TL;DR
O tym, co zrobi agent kodujący, decyduje nie długość promptu, tylko to, co ma w kontekście. Model nie pamięta wcześniejszych rozmów, za każdym razem czyta całą historię od początku, więc błędna informacja szkodzi mu bardziej niż jej brak, a brak bardziej niż zwykły szum. Autor opiera się na relacjach praktyków z OpenAI, Anthropic, WorkOS i Factory oraz na cztero wymiarowym modelu kontekstu Dexa Horthy'ego.
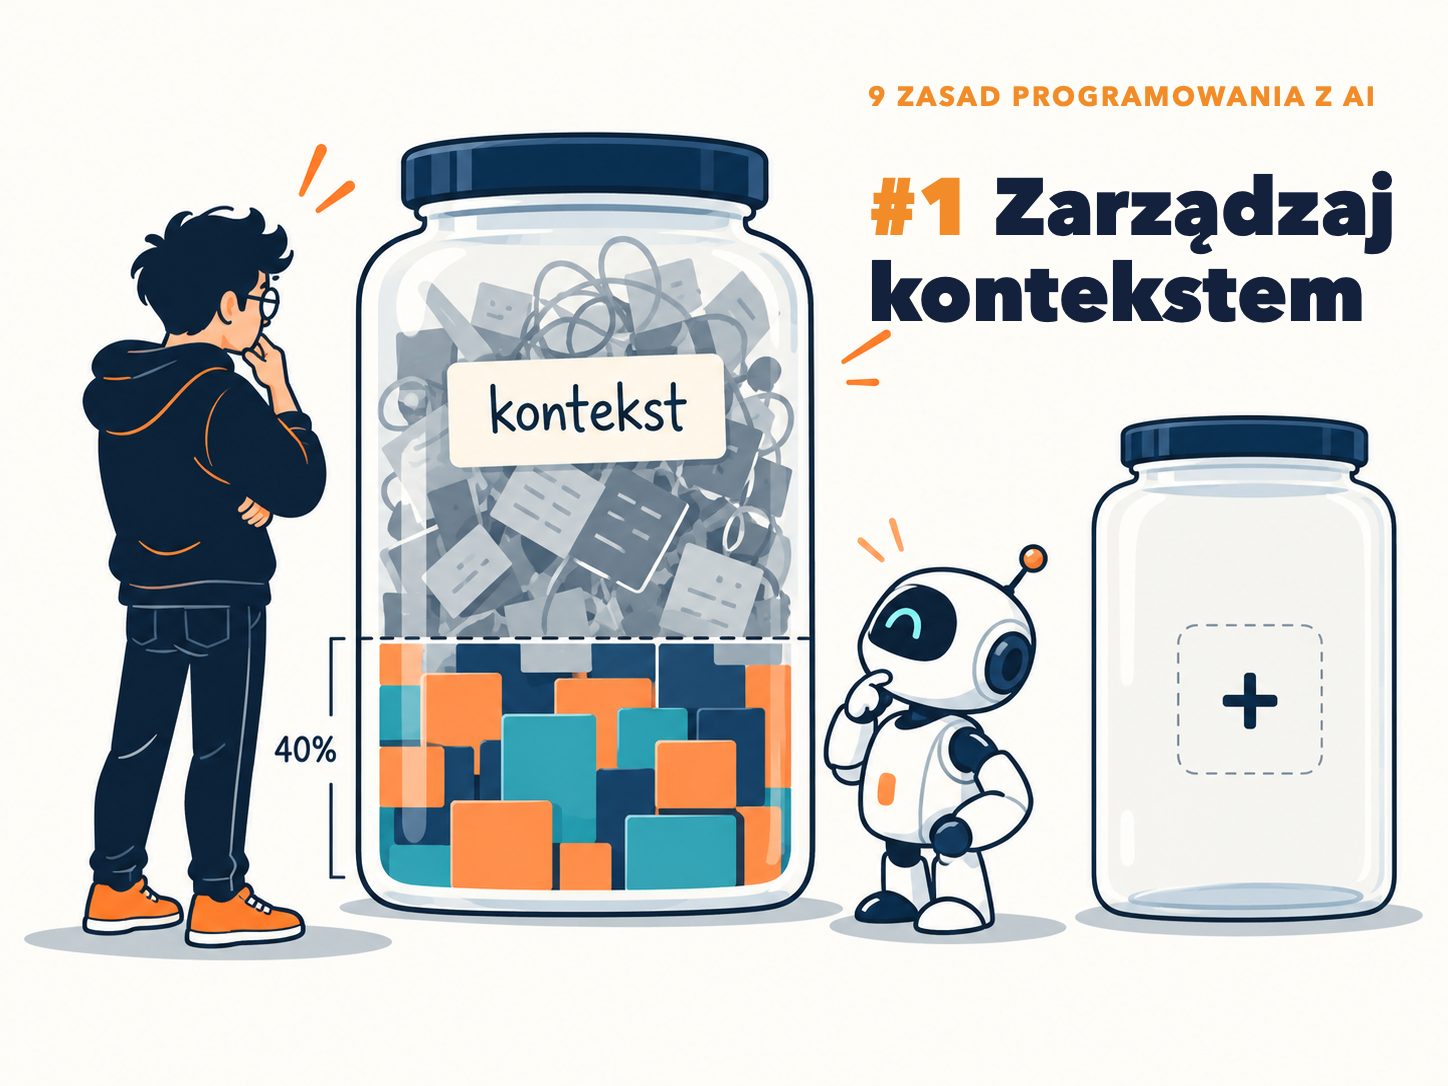
Jakość decyzji ma wyraźnie spadać już przy około 40 procentach zapełnionego okna, czyli w Claude Code mniej więcej przy 168 tys. tokenów. To szacunek z doświadczenia, a nie pomiar, i autor uczciwie to zaznacza. Wnioski są za to bardzo konkretne: wyłączać zbędne serwery MCP, trzymać pliki w okolicach 350 linii, nie drążyć po dwóch nieudanych poprawkach i zamiast tego zrobić świadome streszczenie sesji, poprawić je ręcznie i zacząć od czystego okna. Warto zobaczyć, jak dokładnie wygląda ta technika i dlaczego subagenci według autora nie powinni grać ról frontendowca i QA.
Zaczynam serię o pracy z agentami kodującymi. Zasada #1: o tym, co zrobi agent, decyduje to, co ma w kontekście, a nie długość promptu.
Czytaj cały wpis u źródła